前言
决策树是机器学习中一种非常流行且易于理解的监督学习算法,可用于分类和回归任务。
一、核心概念和结构
树形结构:
根节点: 树的顶端节点,包含整个数据集。代表第一个、最重要的划分特征和条件。
内部节点/决策节点: 代表数据集根据某个特征的某个条件进行的划分。每个节点对应一个特征和一个测试条件(例如,年龄 < 30?,收入 >= 50000?)。
分支/边: 连接节点,表示一个决策的结果(例如,“是”或“否”)。每条分支代表特征测试的一个可能输出。
叶节点/终节点: 树的末端节点,不再进行进一步划分。它包含最终的预测结果(分类任务中是类别标签,回归任务中是数值)。
二、基本构筑
1.如何选择每个节点通过什么特征进行分类:
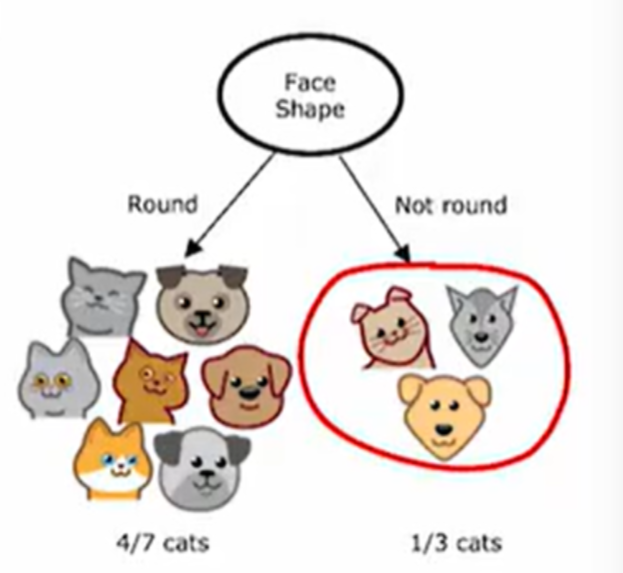
最大化纯度,使用熵来估计杂质
2.什么时候停止分裂:
当节点已经100%是一类了;当如果进一步拆分会超过决策树最大深度;当所造成的纯度的提升小于一个阈值(收益小);当该节点中的元素总数小于一个阈值。
三、熵entropy(H)用于对数据杂质的度量
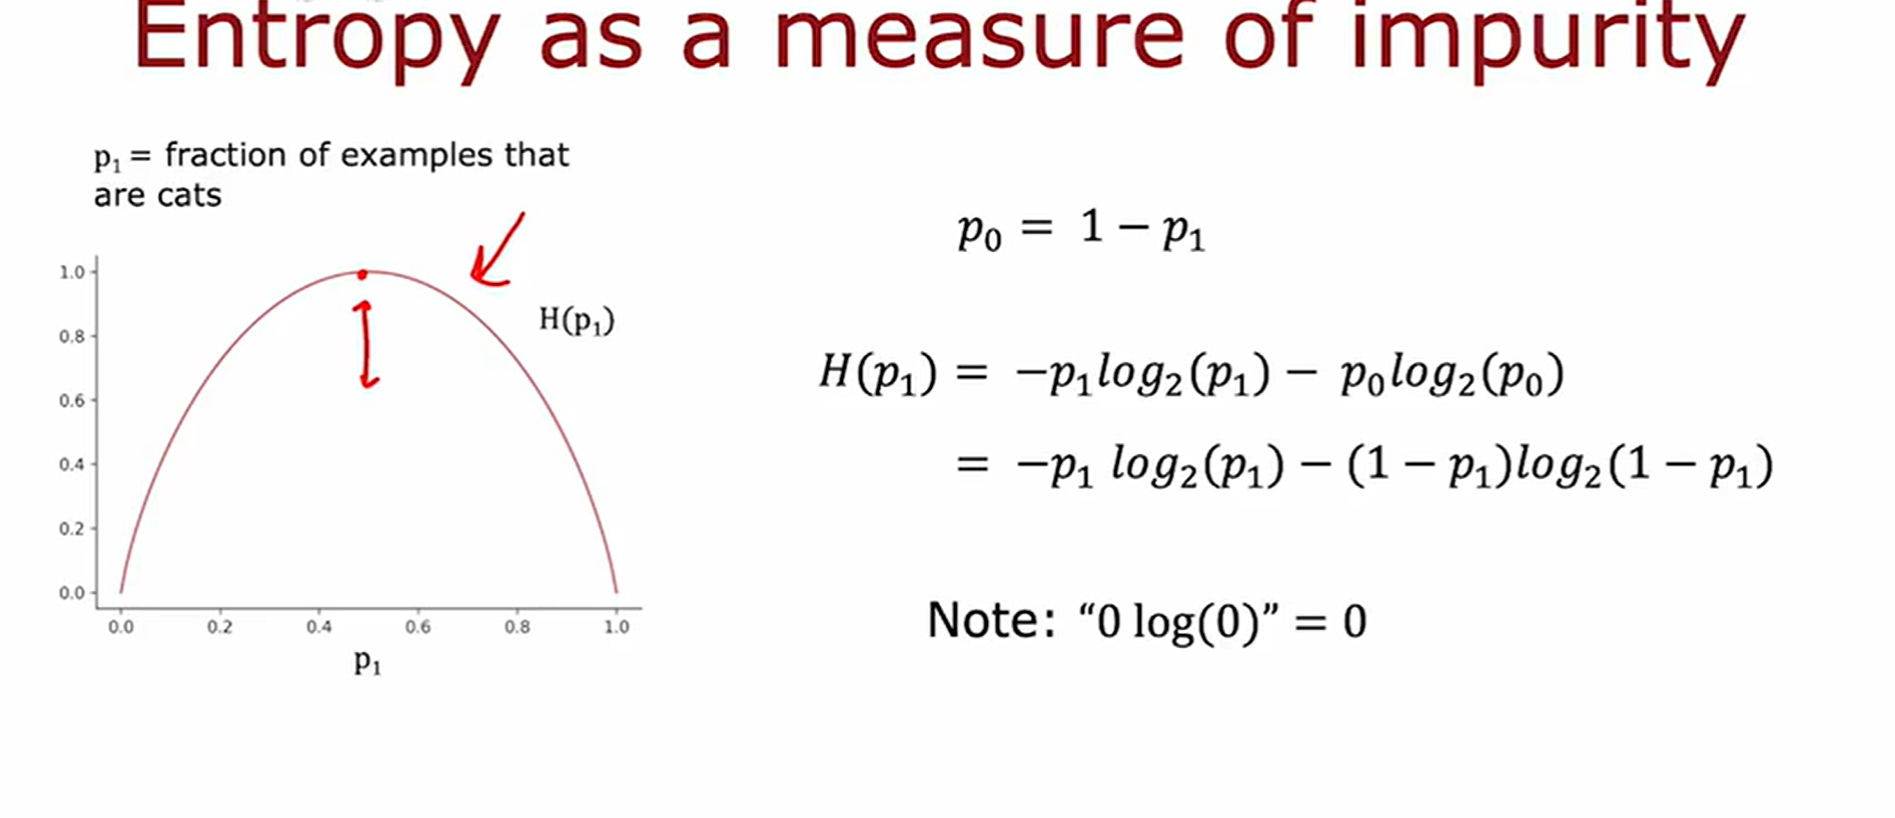
公式如上:其中当数据为五五开时p1=0.5→H(p1)=1即纯度最低。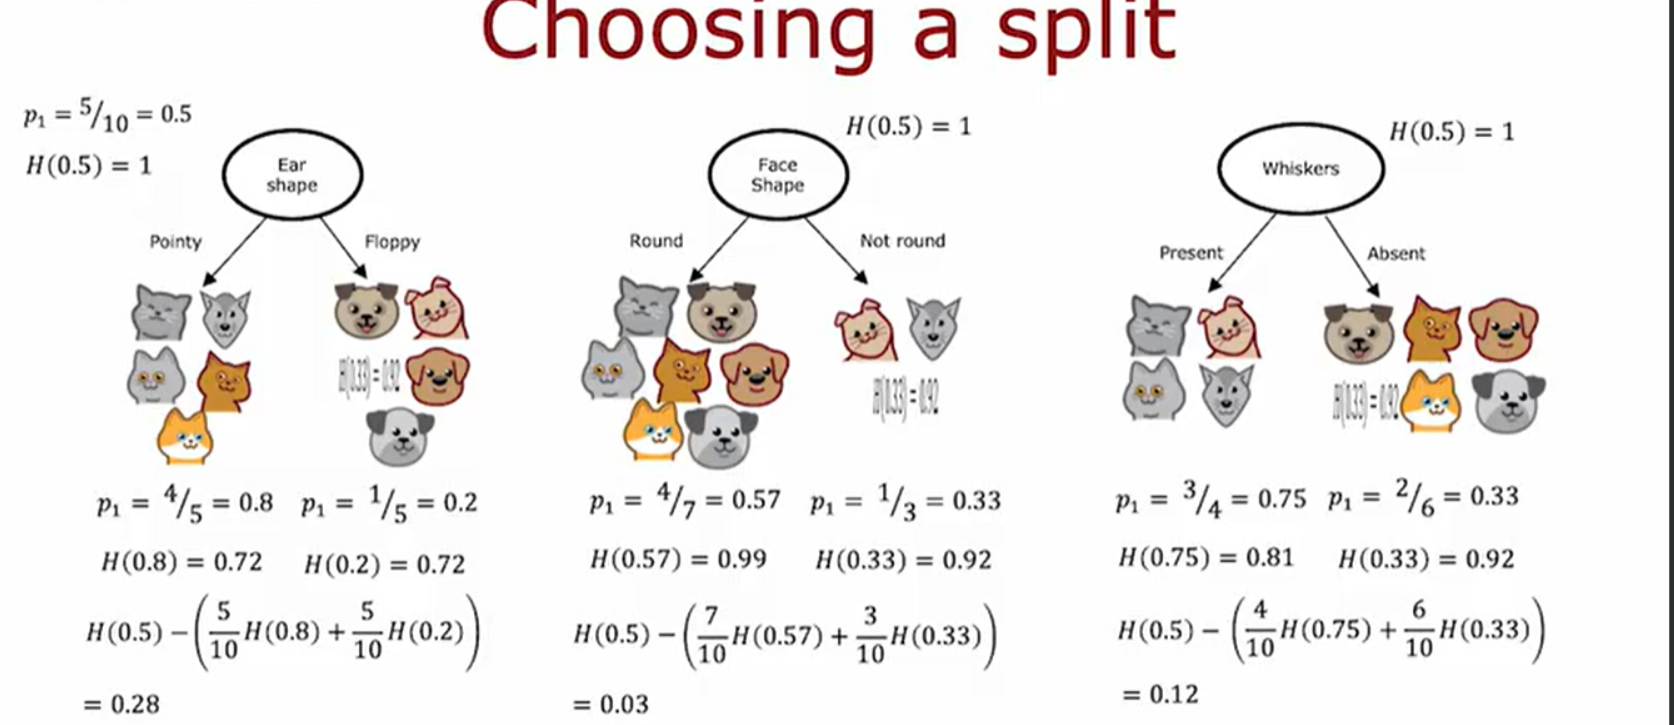
在选择决策树的根部使用哪一个特征时要计算他们的信息熵=该特征分类出的支部所有的熵并以元素个数对熵取加权平均数,计算该根节点的上并计算变化量,选择熵变最大的一个特征作为该节点的特征。
四、如何建立决策树
从根节点处的所有示例开始计算所有可能特征的信息增益,然后选择信息增益最高的一个
根据所选特征拆分数据集,并创建 tree 的 left 和 right分支继续重复拆分过程,直到满足停止条件:
当一个节点 100% 为 1 类时;
当一个节点切分时,会导致树超过一个最大值深度时;
来自其他拆分的信息增益小于阈值时;
当节点中的样本数低于阈值时;
五、补充
热编码:当一个特征对应的结果k≥3种,那就把这k种分别拿出来变为yes or no,但是可能会导致特征膨胀,但是如果进一步全部变为1 or 0的特征可以用神经网络的logistic回归分类器,而不局限于决策树。
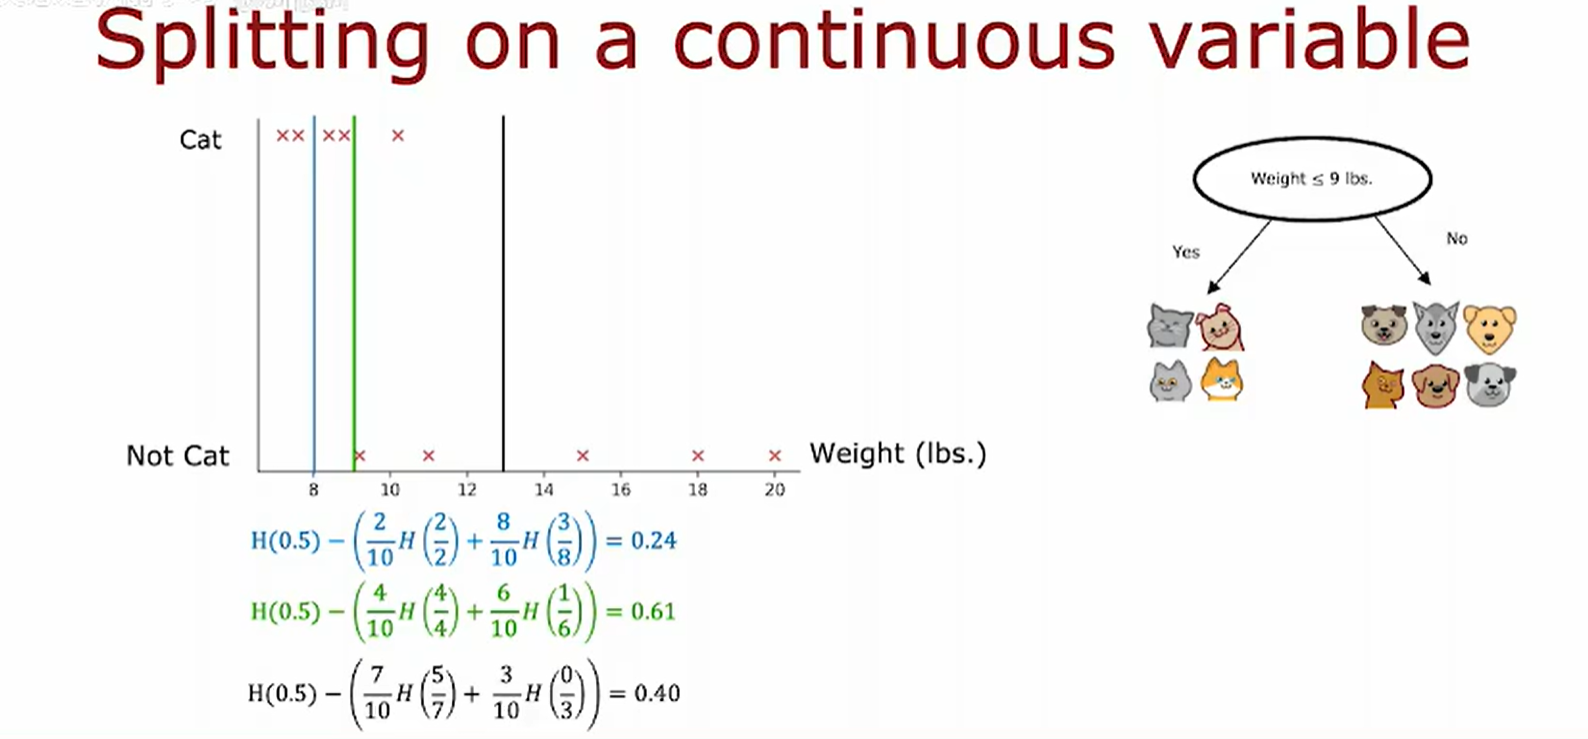
处理连续值时(非离散值)
通过把一个连续变量设置一个(n-1种)阈值分裂后计算加权平均的与原节点的熵增,选择熵增最大的一个阈值。